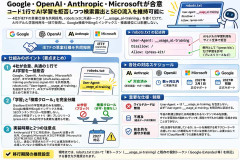
ChatGPTで生成されたイメージです。Googleニュース過去2年間、世界のコンテンツメディアやブログ運営者、サイト管理者にとって、ルートディレクトリにあるrobots.txtファイルのメンテナンスは、まさに終わりのない「モグラ叩き」のような状態だった。新しいAIラボが大規模モデルをリリースするたびに、管理者はその専用クローラー名(GPTBot、ClaudeBot、Google-Extended、CCBotなど)を調べ、ルールを一行ずつ手動でrobots.txtに書き込まなければならなかった。さらに厄介なのは、クローラーを誤ってブロックしてしまい、自社サイトがGoogle検索のインデックスやAIの要約引用から完全に消えてしまうことを多くの人が恐れていた点だ。この断片化した混乱に終止符を打つべく、Google、OpenAI、Anthropic、Microsoftの4社は、異例とも言える歴史的な合意に達した。Anthropicの標準化担当責任者であるKevin Kelley氏がIETF(aiprefワーキンググループ)に提出した最新の草案仕様(draft-kelley-aipref-training-preference-signal-00)を共同で採用・遵守することを正式に発表した。今後、サイト管理者はrobots.txtファイルに「User-Agent: __usage_ai-training」という共通のポリシー・トークンを1行記述するだけで、「大手4社への一括対応」が可能になる。これにより、生成AIモデルの学習へのサイトコンテンツ利用を統一して拒否できると同時に、Google検索やBing検索における正常なクロールや検索順位には一切影響を与えない仕組みが整う。Mashdigi Global出典:Google、OpenAI、Anthropic、Microsoftが合意、コード1行でAI学習を拒否しつつ検索露出とSEO流入を維持可能に Googleユーザーの反応 1.これはサイト運営者にとって朗報だな。AI学習だけ拒否して検索流入を維持できるのはありがたい。 2.今までAIクローラーごとに設定してたのが共通化されるのか。もっと早くやってほしかった。 3.robots.txtに書くだけで済むなら簡単だな。ただし本当に守ってくれるかは別問題。 4.Google検索には表示してほしいけどAIの学習には使われたくない。まさにこういう設定が欲しかった。 5.4社が同じ仕様で合意したのは大きい。ネット全体の標準になってほしい。 6.これ、User-Agentの1行だけじゃなくてDisallow: /も必要なんだよな。そこ勘違いする人が出そう。 7.検索順位に影響しないというのが一番重要。SEOを犠牲にせずAI学習を拒否できるのは助かる。 8.Anthropicはもう対応済みなのにGoogleは2027年からなのか。こういうところは早めに対応してほしい。 9.個人ブログの文章まで勝手に学習される時代だからな。拒否する選択肢があるのはいいこと。 10.過去に学習されたデータは消せないのか。結局これからのコンテンツを守る仕組みなんだな。 11.AI企業の自主的な対応に頼るのが気になる。悪質なクローラーは普通に無視してきそう。 12.Allowで特定のディレクトリだけ学習を許可できるのは便利だな。サイトごとに細かく調整できる。 13.AI検索からの流入も大事だからな。学習拒否とAIによる引用を別々に設定できる方向性は歓迎。 14.MicrosoftのGrounding制御は気になる。学習は禁止してもCopilotからリンク付きで紹介されるなら悪くない。 15.Google-Extendedと新しい設定は当面併用した方がいいのか。移行期間はちょっと面倒そう。 16.robots.txtってアクセスそのものを防ぐ仕組みじゃないからな。そこは理解しておかないと危険。 17.ニュースサイトや攻略サイトには重要な仕様だな。独自に調べた情報をどう扱うか選べるのは大きい。 18.大手4社だけじゃなくて他のAI企業にも広がってほしい。結局個別対応が残るなら完全解決とは言えない。 19.そもそもAI学習を拒否したらAI検索で紹介されにくくなるのかと思ってた。用途を分けて管理できるのは合理的。 20.今後はサイト運営者がAIにコンテンツをどう使わせるか選ぶ時代になるのか。標準化が進むのはいいことだ。 ※上記は記事内容をもとに作成した架空のネット民コメントです。実際の掲示板やSNSから引用したものではありません。 まとめGoogle、OpenAI、Anthropic、Microsoftの4社が、WebサイトのコンテンツをAIモデルの学習に利用させないための共通仕様に合意した。IETFに提出された草案に基づき、サイト管理者はrobots.txtに「User-Agent: __usage_ai-training」と「Disallow: /」を記述することで、対応するAI企業に学習利用の拒否を一括して表明できる。従来のように各社のAIクローラーを個別に設定する手間が減り、Google検索やBing検索のインデックス、SEO流入を維持しながらAI学習のみを制限できる点が特徴だ。また、Allowを使用すれば特定のディレクトリだけ学習を許可することも可能。Anthropicはすでに対応し、OpenAIは数ヶ月以内、GoogleとMicrosoftは2027年初頭の対応を予定している。ただし、過去に学習されたデータには遡及せず、未対応のAI企業やルールを無視するクローラーには効果がない。移行期間中は既存の個別設定との併用が推奨される。 アマゾン商品図解即戦力 Web技術がこれ1冊でしっかりわかる教科書 [改訂2版]…